Uczenie maszynowe bez bariery matematycznej — „Machine learning, Python i data science. Wprowadzenie”
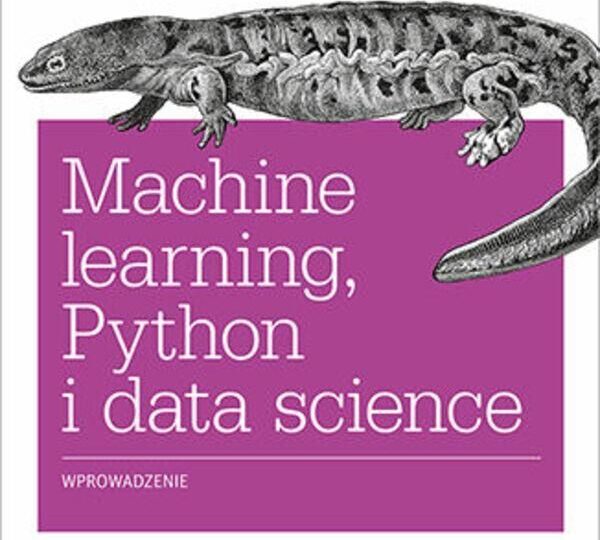
Uczenie maszynowe często bywa przedstawiane jak temat zarezerwowany wyłącznie dla wielkich firm i rozbudowanych zespołów. W praktyce coraz więcej osób tworzy samodzielnie rozwiązania oparte o dane, a dostęp do zasobów statystycznych i narzędzi programistycznych jest dziś nieporównywalnie łatwiejszy niż jeszcze kilka lat temu. Książka „Machine learning, Python i data science. Wprowadzenie” powstała właśnie po to, by przejść od pomysłu do działania — krok po kroku, w podejściu nastawionym na wdrażanie realnych projektów.
Jeśli zniechęca Cię wizja nauki opartej wyłącznie na zaawansowanej matematyce, to dobrze trafiłeś. Autorzy ograniczają warstwę matematyczną do niezbędnego minimum i przesuwają ciężar na praktykę: jak korzystać z algorytmów, jak rozumieć ich zastosowanie oraz jak budować sensowny przepływ pracy w Pythonie. To podejście jest szczególnie ważne dla badaczy, analityków danych i inżynierów, którzy chcą tworzyć aplikacje komercyjne, a nie tylko „przerabiać teorię”.
Wątki informatyczne w tej książce są prowadzone w sposób, który łączy codzienną pracę z danymi z narzędziami, które realnie działają. W naturalny sposób pojawia się też wątek: Machine learning, Python i data science. Wprowadzenie jako punkt startu do dalszej drogi — zarówno dla osób rozpoczynających naukę, jak i tych, którzy potrzebują uporządkowanego, praktycznego przewodnika.
Co dostajesz w środku? Praktyczne podejście do algorytmów i pracy z danymi
Książka koncentruje się na tym, jak wykorzystać szeroką gamę modeli dostępnych w popularnych bibliotekach, zamiast skupiać się na abstrakcyjnych wzorach. Dzięki temu szybciej budujesz zrozumienie: dlaczego dany algorytm działa w określonych warunkach i jak go zastosować, gdy pojawia się konkretny problem biznesowy lub badawczy.
Wśród kluczowych zagadnień znajdziesz m.in. podstawy uczenia maszynowego oraz najważniejsze algorytmy uczenia maszynowego. Ważną częścią jest też przetwarzanie danych w uczeniu maszynowym — czyli to, co w praktyce decyduje o jakości wyników. Następnie książka prowadzi przez ocenę modelu i dostrajanie parametrów, tak aby nie kończyć pracy na etapie „działa na moich danych”.
Autorzy pokazują również, jak myśleć o pipeline’ach: łańcuchach modeli i hermetyzacji przepływu pracy. To podejście pomaga utrzymać porządek w procesie przygotowania danych i trenowania modeli, co jest szczególnie ważne, gdy projekt zaczyna żyć własnym życiem — od prototypu do wdrożenia.
Jest tu także wyraźny wątek „Python i uczenie maszynowe: programowanie do zadań specjalnych”. Oznacza to, że zagadnienia są prowadzone tak, byś potrafił wykorzystać je w kodzie i w praktycznych scenariuszach. Szczególną uwagę poświęcono przetwarzaniu danych tekstowych, co w wielu projektach stanowi ogromną część problemów: klasyfikację treści, analizę opinii czy przygotowanie danych do modeli.
Scikit-learn i realne wdrożenia: dlaczego ta książka jest dla badaczy i analityków
Wiele opracowań o sztucznej inteligencji wymaga matematycznej biegłości, zanim w ogóle da się przejść do budowania rozwiązań. Ta książka odwraca kolejność: najpierw nauka praktycznego sposobu pracy, a potem dopiero — w niezbędnym zakresie — elementy teoretyczne. Dzięki temu szybciej przechodzisz od rozumienia do tworzenia.
Duży nacisk kładzie się na zastosowania Pythona oraz biblioteki scikit-learn. To oznacza, że czytelnik dostaje konkret: jak korzystać z gotowych modeli, jak je zestawiać, jak oceniać wyniki i jak udoskonalać parametry. Dla badaczy i analityków danych liczy się czas oraz możliwość powtarzalnych eksperymentów — książka pomaga budować takie podejście.
Jeśli pracujesz jako inżynier i Twoim celem są aplikacje komercyjne, docenisz sposób prowadzenia tematów: od danych i przetwarzania, przez ocenę jakości, aż po organizację pracy w formie łańcuchów modeli. To jeden z tych praktycznych elementów, które sprawiają, że projekt staje się przewidywalny i łatwiejszy do utrzymania.
Autorzy, którzy łączą doświadczenie z dydaktyką
Za książką stoi zespół autorów z mocnym zapleczem praktycznym. Dr Andreas Müller zajmował się uczeniem maszynowym w aplikacjach rozpoznawania obrazów w Amazonie, a później dołączył do Center for Data Science na New York University. Jest jednym z głównych autorów biblioteki scikit-learn oraz kilku innych pakietów uczenia maszynowego.
Sarah Guido jest analitykiem danych. Pracowała w kilku start-upach i jest ceniona za znakomite wystąpienia na prestiżowych konferencjach. Taki profil autorów przekłada się na styl: książka jest nastawiona na praktykę, ale jednocześnie wyjaśnia zrozumiale, co i po co robisz w kodzie.
W efekcie dostajesz nie tylko listę tematów, ale uporządkowany sposób myślenia o projektowaniu modeli i pracy z danymi — dokładnie taki, który przydaje się, gdy chcesz przejść od nauki do wdrożeń. To właśnie w tym sensie Machine learning, Python i data science. Wprowadzenie działa jak dobry start dla wielu ścieżek: od edukacji po zastosowania w projektach.
| Parametr | Wartość |
|---|---|
| Nazwa | Machine learning, Python i data science. Wprowadzenie |
| SKU | 95d4c94947e0 |
| Cena | 41.01 zł |
| Tematyka | Uczenie maszynowe i sztuczna inteligencja z naciskiem na praktyczne wdrożenia w Pythonie; scikit-learn; przetwarzanie danych (w tym tekstowych); ocena modelu i dostrajanie parametrów; łańcuchy modeli i hermetyzacja przepływu pracy |
| Profil matematyki | Ograniczona do niezbędnego minimum |
| Autorzy | Dr Andreas Müller; Sarah Guido |
Dla kogo ta książka i jak może przyspieszyć Twoją naukę
Jeśli dopiero zaczynasz przygodę z uczeniem maszynowym, otrzymujesz czytelny plan wejścia w temat bez nadmiaru barier. Zamiast utknąć na trudnej matematyce, uczysz się podejścia „zrób i sprawdź”: przygotuj dane, zbuduj model, oceń jakość i popraw wynik poprzez dostrojenie parametrów.
Jeżeli jesteś w trakcie pracy nad projektem, książka pomaga uporządkować typowe kroki: przetwarzanie danych, dobór algorytmów, ocena i iteracje. A gdy w grę wchodzi tekst — pojawia się praktyczne omówienie przetwarzania danych tekstowych, które w wielu zastosowaniach okazuje się kluczowe.
- Uczysz się na praktycznych przykładach, a nie na samych definicjach
- Budujesz pipeline’y dzięki podejściu do łańcuchów modeli i hermetyzacji przepływu pracy
W efekcie książka „Machine learning, Python i data science. Wprowadzenie” staje się sensownym narzędziem w Twojej codziennej pracy: od pierwszych eksperymentów aż po bardziej uporządkowane wdrożenia, w których liczy się powtarzalność i jakość ocen.
Jak wykorzystać scikit-learn, by szybciej przejść od pomysłu do działania
Jednym z największych atutów tej książki jest to, że pokazuje, jak korzystać z modeli dostępnych w popularnych bibliotekach. Dzięki temu możesz skupić się na tym, co naprawdę ważne w projekcie: na danych, na tym jak je przetwarzasz, i na tym, jak weryfikujesz działanie modelu.
W praktyce oznacza to, że dostajesz narzędzia do pracy z algorytmami w sposób, który ma sens w realnych warunkach. Ocenianie modelu i dostrajanie parametrów nie jest tu dodatkiem, tylko częścią procesu. To samo dotyczy organizacji pracy — łańcuchy modeli i hermetyzacja przepływu pracy pomagają zmniejszyć chaos i ułatwiają dalszy rozwój projektu.
Jeśli interesuje Cię ścieżka „Machine learning, Python i data science. Wprowadzenie” jako fundament, to ta książka działa jak przewodnik po praktycznych krokach. Wprowadza w temat tak, byś mógł tworzyć rozwiązania, które da się utrzymać, rozwijać i wdrażać.